Sous le microscope : un cadre stratégique pour surveiller vos API REST
##Présentation
Les API (Application Programming Interfaces) sont devenues des composants essentiels des applications et services logiciels modernes. Les API permettent à différents systèmes de communiquer entre eux et d’échanger des données. L’un des paradigmes de conception d’API les plus courants et les plus largement adoptés est REST (Representational State Transfer).
Les API REST offrent aux applications un moyen puissant et léger d’interagir sur Internet. Ils fonctionnent en utilisant le protocole HTTP et les principes d’apatridie. Cela les rend évolutifs, flexibles et faciles à utiliser pour n’importe quel client.
À mesure que les organisations adoptent des modèles de microservices et investissent dans le développement d’API d’abord, elles se retrouvent avec des dizaines, voire des centaines d’API REST. Ces API alimentent les fonctions commerciales critiques et les expériences client. De mauvaises performances de l’API ou des temps d’arrêt peuvent avoir un impact direct sur les revenus et la réputation.
C’est pourquoi une surveillance et une observabilité diligentes sont essentielles pour les API REST. Sans une surveillance appropriée, les problèmes peuvent passer inaperçus jusqu’à ce que les clients commencent à se plaindre. Les appels d’API lents ou échoués peuvent créer des frustrations et avoir un impact négatif sur l’expérience utilisateur. La surveillance offre la visibilité nécessaire pour maintenir les API saines et performantes de manière optimale.
La surveillance proactive permet aux équipes de détecter les anomalies et de résoudre les problèmes avant qu’ils ne se transforment en pannes. Il permet également de comprendre les modèles d’utilisation et d’optimiser la conception des API. En bref, la surveillance est indispensable pour garantir la disponibilité, la fiabilité et la qualité des API REST. Ce guide couvre les stratégies clés et les meilleures pratiques pour une surveillance efficace des API REST.
Définir vos objectifs de surveillance
La surveillance de l’état et des performances de vos API REST est cruciale, mais il est important de définir vos objectifs de surveillance spécifiques avant de mettre en œuvre une solution. Cela garantit que vous suivez les bonnes mesures qui offrent une visibilité sur les problèmes d’API qui ont réellement un impact sur votre entreprise ou vos clients. Quelques objectifs clés à considérer :
Performances – Quelles sont les performances de vos API ? Les mesures clés incluent la disponibilité de l’API, la latence, les taux d’erreur (codes d’état 4XX, 5XX), le débit et la consommation des ressources. La surveillance de ces métriques révélera des problèmes et des dégradations de performances. Établissez des objectifs de niveau de service (SLO) internes pour une latence, une disponibilité et des taux d’erreur acceptables des API.Utilisation et adoption – L’utilisation de l’API est-elle en croissance ? De nouveaux points de terminaison sont-ils touchés ? Suivez des mesures telles que le nombre total de demandes, les demandes par point de terminaison, la taille des réponses et les tendances au fil du temps. La surveillance des modèles d’utilisation vous aide à identifier les API et les points de terminaison adoptés, à repérer les API sous-utilisées et à éclairer les futurs efforts de développement d’API.
Impact sur l’entreprise – Quel est l’impact des problèmes de performances des API sur les KPI de l’entreprise ? Corrélez les mesures de santé des API avec les mesures commerciales telles que les taux de conversion, les revenus, l’engagement des utilisateurs, etc. Cela vous permet de quantifier l’impact commercial des dégradations des API. Par exemple, des API lentes peuvent réduire directement les conversions et les revenus. La surveillance de cette corrélation vous permet de donner la priorité à la correction des API les plus importantes pour l’entreprise.
Définir clairement vos objectifs de surveillance des API vous permettra de suivre les bonnes mesures, d’être alerté des problèmes importants et d’obtenir des informations sur la relation entre la santé des API et les performances de l’entreprise.
Métriques API clés à suivre
La surveillance des API REST nécessite le suivi de plusieurs indicateurs de performance clés (KPI) et métriques. Cela donne un aperçu de la santé globale, de l’utilisation et de la valeur commerciale d’une API. Certaines des métriques API les plus importantes à surveiller incluent :
Temps de réponse : mesuré en millisecondes, le temps de réponse indique la rapidité avec laquelle une API répond aux requêtes. Des temps de réponse lents ont un impact négatif sur l’expérience utilisateur et peuvent indiquer des problèmes de mise à l’échelle. Les temps de réponse cibles dépendent de l’API, mais des temps inférieurs à la seconde sont idéaux pour les API destinées aux utilisateurs.
Taux d’erreur : pourcentage de requêtes entraînant des erreurs, telles que 400 ou 500 codes d’état. Des taux d’erreur élevés révèlent des problèmes liés à la mise en œuvre des API, aux backends ou aux modèles d’utilisation. Essayez de maintenir le taux d’erreur en dessous de 1 à 2 %.
Disponibilité : pourcentage de temps pendant lequel une API est accessible et répond aux demandes. Une haute disponibilité, telle que 99,9 %, est attendue pour les API de production. Les problèmes de disponibilité indiquent des problèmes de back-end ou des pannes d’infrastructure.
Volume de trafic : nombre de requêtes API au fil du temps, généralement mesuré par seconde, minute ou jour. Le volume du trafic indique l’adoption et l’utilisation de l’API. Un trafic inhabituellement élevé ou faible peut refléter des problèmes. Comprendre les modèles de trafic réguliers facilite la mise à l’échelle.
Performances du cache : pour les API avec mise en cache activée, le taux de réussite du cache et la latence du cache ont un impact sur les performances. Les taux élevés de réussite du cache minimisent les appels aux services backend. Surveillez les métriques du cache pour affiner les configurations.Adoption API : nombre de développeurs ou d’applications actifs utilisant une API. Les mesures d’adoption démontrent la valeur commerciale et aident à prévoir les besoins en capacité. Ceux-ci incluent les inscriptions, les utilisateurs actifs mensuels et les taux de croissance.
Le suivi des métriques dans ces catégories fournit une vue globale de la santé des API, de l’expérience utilisateur et des opérations. Les équipes peuvent découper les données par point de terminaison, région, utilisateur et autres dimensions pour obtenir des informations plus approfondies. La prochaine étape consiste à rassembler les bons outils pour capturer, analyser et alerter sur ces données de métriques.
Outils pour la surveillance des API
La surveillance d’une API REST nécessite généralement un outil de surveillance dédié conçu pour les API. Il existe des outils open source et commerciaux qui offrent des capacités de surveillance des API :
Outils Open Source
-
Prometheus - Une boîte à outils open source populaire de surveillance et d’alerte, Prometheus peut être utilisé pour surveiller la disponibilité des API, la latence des requêtes, les taux d’erreur, etc. Il collecte des métriques via un modèle HTTP pull, dans lequel les serveurs Prometheus récupèrent les métriques des cibles configurées. Prometheus fonctionne bien pour surveiller les microservices et les API individuels.
-
Grafana - Bien qu’il ne s’agisse pas d’un outil de surveillance en soi, Grafana est une plateforme d’analyse et de visualisation open source couramment utilisée avec des outils de surveillance comme Prometheus. Grafana vous permet de créer des tableaux de bord pour visualiser les métriques collectées par Prometheus.
Outils commerciaux
-
Datadog - Service de surveillance commerciale leader, Datadog offre une visibilité complète sur les performances des API. Il peut suivre les erreurs d’API, la latence, le trafic et la saturation. Datadog facilite la configuration de tableaux de bord personnalisés et d’alertes spécialement conçues pour la surveillance des API.
-
New Relic - Plateforme de gestion des performances populaire, New Relic offre des fonctionnalités complètes de surveillance des API, notamment des mesures sur le débit, les temps de réponse et les taux d’erreur. Il vous permet d’instrumenter le code API pour un traçage détaillé et une surveillance des journaux. New Relic fournit des tableaux de bord personnalisables et une intégration avec d’autres outils.
La combinaison de Prometheus et Grafana fournit une pile de surveillance open source complète adaptée à la plupart des besoins des API. Pour ceux qui recherchent un service géré doté de fonctionnalités avancées, Datadog et New Relic sont les principales options commerciales. Le bon outil dépendra de l’échelle, de la complexité et des besoins de surveillance de votre infrastructure API.
Construire une stratégie d’alerteUne stratégie efficace de surveillance des API nécessite la configuration d’alertes pour vous avertir lorsque des problèmes surviennent. Il existe deux principaux types d’alertes à considérer :
Alertes basées sur un seuil
Les alertes basées sur un seuil sont déclenchées lorsqu’une métrique dépasse un seuil défini. Par exemple, vous souhaiterez peut-être être averti si le taux d’erreur de l’API dépasse 5 % ou si le temps de réponse P99 dépasse 1 seconde.
Lors de la définition des seuils, examinez les valeurs historiques des mesures pendant le fonctionnement normal et définissez les déclencheurs d’alerte légèrement en dehors de cette référence. Cela permet d’éviter les faux positifs tout en détectant les événements significatifs.
Alertes de détection d’anomalies
La détection des anomalies va au-delà des seuils statiques en alertant sur des modèles de métriques inhabituels. Cela permet de détecter des événements tels qu’une lente dégradation des performances au fil du temps.
La détection des anomalies fonctionne en analysant les données historiques pour créer un modèle de comportement normal. Des écarts importants par rapport à cette référence déclencheront une alerte. Cette approche nécessite un historique de métriques suffisant, mais peut révéler des problèmes que les alertes basées sur des seuils peuvent manquer.
Intégration des systèmes de notification
Pour tirer le meilleur parti des alertes, intégrez-les à des systèmes capables d’agir. Les options incluent le courrier électronique, les SMS, les applications de chat et les outils de gestion des incidents comme PagerDuty.
Les intégrations de notifications permettent de communiquer rapidement les problèmes à l’équipe responsable. Cela permet une enquête et une résolution plus rapides afin de minimiser les temps d’arrêt des API.
Les actions automatisées telles que la mise à l’échelle automatique des groupes ou l’exécution de playbooks peuvent également contribuer à réduire l’impact des problèmes d’API. Déterminez quelles notifications et réponses sont appropriées en fonction de la gravité des différentes alertes.
Visualisation et analyse des données de santé de l’API
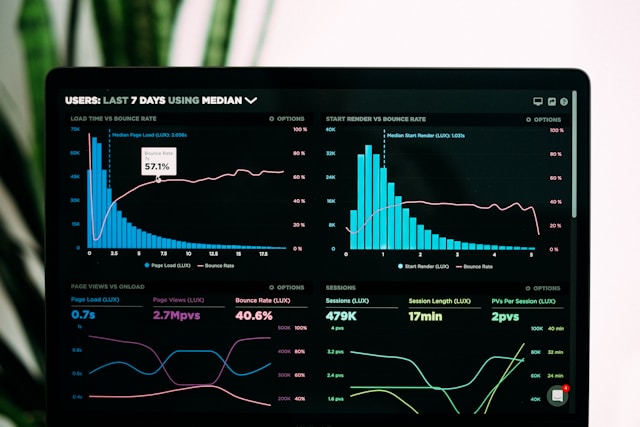
Une fois que vous avez commencé à collecter des métriques, l’étape suivante consiste à visualiser et analyser les données pour obtenir des informations sur les performances et l’état de l’API. La création de tableaux de bord personnalisés est cruciale pour surveiller la santé des API. Plutôt que de simplement observer des flux de mesures brutes, un tableau de bord bien conçu peut faire apparaître en un coup d’œil les principales tendances, anomalies et informations.
Certaines fonctionnalités importantes à rechercher lors de la sélection des outils de tableau de bord incluent :
-
Corrélation visuelle des métriques - Affichez les métriques côte à côte pour découvrir les relations. Par exemple, tracez le taux d’erreur par rapport au trafic pour voir si les erreurs augmentent en cas de charge élevée.
-
Analyse historique - Comparez les tendances actuelles au comportement passé pour détecter les anomalies. Visualisez les tendances à long terme à un niveau élevé.
-
Graphiques flexibles - Personnalisez les graphiques à l’aide de différents types de graphiques, de fenêtres déroulantes et de vues statistiques telles que les centiles.- Annotation et collaboration - Ajoutez du contexte aux graphiques et partagez les résultats avec vos collègues.
-
Accès programmatique - Intégrez les données du tableau de bord aux alertes, aux flux de travail et à d’autres systèmes.
-
Tableaux de bord prédéfinis et personnalisés - Utilisez des modèles prédéfinis et créez des vues personnalisées pour différentes équipes et scénarios.
Grâce à des tableaux de bord perspicaces en place, les équipes API peuvent identifier de manière proactive les problèmes avant qu’ils ne dégénèrent ou n’aient un impact sur les clients. Recherchez des tendances telles qu’une latence croissante, des pics de trafic corrélés à davantage d’erreurs ou des taux d’erreur 5xx anormaux. Partagez des tableaux de bord avec d’autres équipes telles que l’ingénierie et le support client pour déboguer les problèmes. Rendez les tableaux de bord faciles à comprendre pour les parties prenantes non techniques afin de communiquer l’état de santé des API dans toute l’organisation.
Surveillance de l’utilisation et de l’adoption des API
Comprendre comment votre API est utilisée et adoptée est essentiel pour garantir qu’elle génère de la valeur. Voici quelques indicateurs clés à suivre :
Volume d’appels d’API
-
Surveillez le volume total d’appels API au fil du temps pour repérer les tendances à la hausse ou à la baisse. Des pics ou des baisses soudaines de trafic peuvent indiquer des problèmes.
-
Segmentez le trafic API par point de terminaison pour voir lesquels sont les plus/moins populaires. Cela peut guider les futurs efforts de développement d’API.
-
Suivez les centiles des temps de réponse (par exemple, le 95e centile) pour surveiller les performances de l’API. Des temps de réponse plus longs peuvent indiquer des problèmes d’évolutivité.
Répartition des utilisateurs et des applications
-
Analysez l’utilisation de l’API par développeur/application pour comprendre l’adoption par l’ensemble de votre base de consommateurs d’API.
-
Identifiez les consommateurs les plus importants et les plus faibles. Contactez les principaux consommateurs pour découvrir ce qui motive leur utilisation.
-
Surveillez les pics d’utilisation suspects d’applications particulières qui peuvent indiquer un abus.
Surveiller l’accès à la documentation de l’API
-
Suivez les pages vues pour les documents de référence de l’API afin d’évaluer l’intérêt des développeurs.
-
Découvrez quels extraits de code/exemples sont les plus consultés. Cela donne un aperçu des fonctionnalités d’API qui intéressent le plus les développeurs.
-
Surveiller les requêtes de recherche de documents API pour identifier les lacunes dans la couverture de la documentation. Les recherches fréquentes de sujets non documentés indiquent que les développeurs ont besoin de plus d’informations sur l’API.
La surveillance de l’adoption de l’API via des mesures telles que le volume d’appels, le temps de réponse et l’accès à la documentation est essentielle pour garantir que votre API fournit la valeur souhaitée. Les informations d’utilisation obtenues vous permettent de prendre des décisions basées sur les données concernant les améliorations de l’API, l’évolutivité, la sécurité et la documentation.
Corrélation de la santé de l’API avec les métriques commercialesLa surveillance de l’état technique de vos API fournit des informations cruciales, mais pour maximiser l’impact commercial, vous devez corréler les performances des API avec les KPI clés de l’entreprise. Cela vous permet de quantifier l’impact sur les revenus des problèmes d’API et d’établir des priorités en conséquence.
Surveillance de l’impact sur les revenus
-
Suivez les transactions via l’API et corrélez-les avec les données de revenus. Cela vous permet d’identifier l’impact sur les revenus d’un temps d’arrêt de l’API ou d’une dégradation des performances.
-
Mettre en place une surveillance des taux d’erreur API à chaque étape des flux de travail de transaction. Analysez comment les erreurs d’API affectent les principaux entonnoirs et conversions.
-
Comparez les métriques d’utilisation de l’API entre les segments de clientèle. Découvrez si les problèmes de performances des API ont un impact disproportionné sur les clients à forte valeur ajoutée.
Suivi de l’engagement des utilisateurs
-
Mesurez les taux d’inscription et de rétention des consommateurs d’API. Une mauvaise fiabilité des API est souvent directement corrélée à un moindre engagement des utilisateurs.
-
Surveiller l’adoption des nouvelles fonctionnalités de l’API. Une baisse d’utilisation pourrait indiquer des problèmes de qualité de l’API plutôt qu’un manque d’intérêt.
-
Recherchez des corrélations entre les taux d’erreur de l’API et les commentaires des utilisateurs. Les plaintes des clients font souvent état de problèmes d’API.
La surveillance proactive de l’impact commercial des API garantit que les équipes techniques et produits sont alignées sur les priorités. Grâce aux données quantifiées sur les revenus et l’engagement, vous pouvez cibler les améliorations techniques pour maximiser la valeur commerciale.
Meilleures pratiques pour la surveillance des API
Pour établir une stratégie efficace de surveillance des API, vous devez suivre quelques bonnes pratiques clés :
-
Ayez des objectifs mesurables - Définissez des objectifs quantifiables en matière de disponibilité, de latence, de taux d’erreur et d’autres mesures afin de savoir si votre API répond aux attentes. Avoir des objectifs clairs facilite l’identification rapide des problèmes.
-
Surveillez en continu, pas seulement lorsque des problèmes surviennent - Ne vous contentez pas de vérifier l’état de votre API lorsque des problèmes surviennent. La surveillance continue donne un aperçu des performances de base et permet de détecter les anomalies.
-
Automatisez autant que possible - La surveillance manuelle prend du temps et est inefficace. La surveillance automatisée vous permet de suivre l’état de l’API 24h/24 et 7j/7 et d’être rapidement alerté des problèmes. L’automatisation permet également d’adapter la surveillance à mesure que l’utilisation augmente.
-
Concentrez-vous sur l’expérience utilisateur - Concentrez-vous sur la façon dont les performances de l’API affectent vos utilisateurs finaux, et pas seulement sur les mesures techniques. La surveillance synthétique peut simuler des scénarios utilisateur pour aider à surveiller la santé des API du point de vue de l’utilisateur.- Définissez judicieusement les alertes - Les alertes sont essentielles pour une détection rapide des problèmes, mais définir un trop grand nombre d’alertes peut entraîner une fatigue des alertes. Définissez des seuils significatifs et personnalisez les alertes en fonction de la priorité.
-
Intégrez la surveillance aux outils existants - Tirez parti de votre pipeline de livraison de logiciels, de vos outils de journalisation et d’APM existants pour obtenir un aperçu mieux intégré de l’état de votre API.
-
Surveillez les dépendances tierces - Ne vous contentez pas de surveiller vos propres API, suivez également l’état des services et des bases de données tiers dont dépend votre API.
-
Corréler la santé des API avec les KPI de l’entreprise - Associer les données de surveillance des API aux mesures commerciales clés pour comprendre l’impact de la santé des API sur les principaux objectifs commerciaux. Cela permet de démontrer le retour sur investissement des efforts de surveillance.
Conclusion
Les API constituent un élément essentiel de l’architecture de toute application moderne. À mesure que votre utilisation augmente, la surveillance de l’état et des performances de vos API devient d’une importance cruciale. En établissant des objectifs et des mesures clairs, en sélectionnant les bons outils de surveillance et en créant des alertes robustes, vous pouvez garder le doigt sur les performances de l’API.
Les principaux points à retenir sont :
-
Définissez des objectifs de surveillance en fonction des objectifs commerciaux, tels que la disponibilité, la latence et les taux d’erreur.
-
Suivez les mesures d’utilisation telles que le débit, les sources de trafic, les temps de réponse et les erreurs. Surveillez tous les environnements.
-
Utilisez des outils spécialement conçus pour collecter, visualiser et alerter sur les métriques API. Intégrez-vous aux solutions de journalisation et APM existantes.
-
Définissez des seuils et configurez des alertes intelligentes pour détecter les anomalies et éviter que les problèmes ne passent inaperçus.
-
Analyser les tendances au fil du temps pour optimiser les performances et éviter les problèmes. Corrélez la santé des API avec les KPI de l’entreprise.
-
Automatisez la surveillance et faites-en une priorité dans toutes les équipes. Suivez les meilleures pratiques pour les API prêtes pour la production.
La surveillance vous donne les informations dont vous avez besoin pour assurer le bon fonctionnement des API. En établissant une stratégie de surveillance solide, vous pouvez ravir vos développeurs et vos clients avec des API réactives, fiables et résilientes. L’effort demandé en vaut la peine.
Restez à l’écoute avec APIRobots pour plus d’informations et de mises à jour sur ce domaine passionnant. Ne manquez pas les opportunités que les API peuvent apporter à votre entreprise. Contactez-nous dès aujourd’hui à API Robots une agence de développement d’API et libérons ensemble tout le potentiel des API.