顕微鏡の下で: REST API を監視するための戦略的フレームワーク
はじめに
API (アプリケーション プログラミング インターフェイス) は、最新のソフトウェア アプリケーションおよびサービスの重要なコンポーネントになっています。 API を使用すると、異なるシステムが相互に通信し、データを交換できるようになります。最も一般的で広く採用されている API 設計パラダイムの 1 つは、REST (Representational State Transfer) です。
REST API は、アプリケーションがインターネット上で対話するための強力かつ軽量な方法を提供します。これらは、HTTP プロトコルとステートレスの原則を使用して動作します。これにより、拡張性と柔軟性が向上し、どのクライアントからも簡単に利用できるようになります。
組織がマイクロサービス パターンを採用し、API ファーストの開発に投資すると、最終的には数百とは言わないまでも数十の REST API が存在します。これらの API は、重要なビジネス機能と顧客エクスペリエンスを強化します。 API のパフォーマンスの低下やダウンタイムは、収益や評判に直接影響を与える可能性があります。
このため、REST API には入念な監視と可観測性が不可欠です。適切な監視がなければ、顧客から苦情が出るまで問題が検出されない可能性があります。 API 呼び出しが遅いか失敗すると、フラストレーションが生じ、ユーザー エクスペリエンスに悪影響を及ぼす可能性があります。モニタリングは、API を健全に保ち、最適なパフォーマンスを維持するために必要な可視性を提供します。
プロアクティブな監視により、チームは異常を検出し、障害が連鎖的に起こる前に問題を解決できます。また、使用パターンを理解し、API 設計を最適化するのにも役立ちます。つまり、REST API の可用性、信頼性、品質を確保するには監視が不可欠です。このガイドでは、REST API を効果的に監視するための主要な戦略とベスト プラクティスについて説明します。
モニタリングの目標を定義する
REST API の健全性とパフォーマンスを監視することは非常に重要ですが、ソリューションを実装する前に具体的な監視目標を定義することが重要です。これにより、ビジネスや顧客に真の影響を与える API の問題を可視化する適切な指標を追跡できるようになります。考慮すべき重要な目標は次のとおりです。
パフォーマンス - API のパフォーマンスはどの程度ですか?主要なメトリクスには、API 稼働時間、レイテンシー、エラー率 (4XX、5XX ステータス コード)、スループット、リソース消費量が含まれます。これらのメトリクスを監視すると、パフォーマンスの問題や低下が明らかになります。許容可能な API 遅延、稼働時間、およびエラー率に関する内部サービス レベル目標 (SLO) を確立します。使用と導入 - API の使用は増加していますか?新しいエンドポイントがヒットしていますか?合計リクエスト、エンドポイントごとのリクエスト、応答サイズ、経時的な傾向などのメトリクスを追跡します。使用パターンを監視することは、どの API とエンドポイントが採用されているかを特定し、十分に活用されていない API を特定し、今後の API 開発の取り組みに情報を提供するのに役立ちます。
ビジネスへの影響 - API パフォーマンスの問題はビジネス KPI にどのような影響を与えますか? API 健全性メトリクスを、コンバージョン率、収益、ユーザー エンゲージメントなどのビジネス メトリクスと関連付けます。これにより、API の低下がビジネスに与える影響を定量化できます。たとえば、API が遅いと、コンバージョンと収益が直接減少する可能性があります。この相関関係を監視することで、ビジネスにとって最も重要な API の修正に優先順位を付けることができます。
API 監視の目標を明確に定義すると、適切な指標を追跡し、重要な問題についてアラートを受け取り、API の健全性とビジネス パフォーマンスの関係について洞察を得ることができます。
追跡する主要な API メトリクス
REST API を監視するには、いくつかの主要業績評価指標 (KPI) と指標を追跡する必要があります。これにより、API の全体的な健全性、使用状況、ビジネス価値についての洞察が得られます。監視すべき最も重要な API メトリクスには、次のようなものがあります。
応答時間 - ミリ秒単位で測定される応答時間は、API がリクエストにどれだけ速く応答するかを示します。応答時間が遅いとユーザー エクスペリエンスに悪影響があり、スケーリングの問題が発生する可能性があります。目標応答時間は API によって異なりますが、ユーザー向け API では 1 秒未満が理想的です。
エラー率 - 400 または 500 ステータス コードなどのエラーが発生したリクエストの割合。エラー率が高い場合は、API 実装、バックエンド、または使用パターンに問題があることが明らかになります。エラー率を 1 ~ 2% 未満に抑えることを目指してください。
可用性 - API がアクセス可能でリクエストに応答している時間の割合。実稼働 API では、99.9% などの高可用性が期待されます。可用性の問題は、バックエンドの問題またはインフラストラクチャの停止を示しています。
トラフィック量 - 一定期間にわたる API リクエストの数。通常、秒、分、または日ごとに測定されます。トラフィック量は API の採用と利用状況を示します。トラフィックが異常に多いまたは少ない場合は、問題が反映されている可能性があります。通常のトラフィック パターンを理解すると、スケーリングに役立ちます。
キャッシュ パフォーマンス - キャッシュが有効になっている API の場合、キャッシュ ヒット率とキャッシュ レイテンシはパフォーマンスに影響します。キャッシュ ヒット率が高いため、バックエンド サービスへの呼び出しが最小限に抑えられます。キャッシュメトリクスを監視して構成を微調整します。API 導入 - API を使用しているアクティブな開発者またはアプリケーションの数。導入指標はビジネス価値を実証し、容量のニーズを予測するのに役立ちます。これらには、サインアップ、月間アクティブ ユーザー、増加率が含まれます。
これらのカテゴリ全体でメトリクスを追跡することで、API の健全性、ユーザー エクスペリエンス、および操作を総合的に把握できます。チームは、エンドポイント、地域、ユーザー、その他の次元ごとにデータを細分化して、より深い洞察を得ることができます。次のステップは、このメトリクス データをキャプチャ、分析、アラートするための適切なツールを統合することです。
API モニタリング用ツール
REST API を監視するには、通常、API 用に設計された専用の監視ツールが必要です。 API 監視機能を提供するオープン ソース ツールと商用ツールの両方が利用可能です。
オープンソース ツール
-
Prometheus - 人気のあるオープンソースの監視およびアラート ツールキットである Prometheus を使用して、API 稼働時間、リクエスト レイテンシ、エラー率などを監視できます。 Prometheus サーバーが構成されたターゲットからメトリクスを収集する HTTP プル モデルを通じてメトリクスを収集します。 Prometheus は、個々のマイクロサービスと API の監視に適しています。
-
Grafana - Grafana は、それ自体は監視ツールではありませんが、Prometheus などの監視ツールで一般的に使用されるオープンソースの分析および視覚化プラットフォームです。 Grafana を使用すると、Prometheus によって収集されるメトリクスを視覚化するダッシュボードを作成できます。
商用ツール
-
Datadog - 主要な商用監視サービスである Datadog は、API パフォーマンスの完全な可視性を提供します。 API エラー、レイテンシ、トラフィック、飽和を追跡できます。 Datadog を使用すると、API モニタリング用に特別に調整されたカスタム ダッシュボードとアラートを簡単にセットアップできます。
-
New Relic - 人気のあるパフォーマンス管理プラットフォームである New Relic は、スループット、応答時間、エラー率に関するメトリクスを含む包括的な API モニタリング機能を提供します。これにより、詳細なトレースとログ監視のための API コードをインストルメント化できます。 New Relic は、カスタマイズ可能なダッシュボードと他のツールとの統合を提供します。
Prometheus と Grafana を組み合わせることで、ほとんどの API ニーズに適したフル機能のオープンソース監視スタックが提供されます。高度な機能を備えたマネージド サービスを求めるユーザーにとって、Datadog と New Relic は主要な商用オプションです。適切なツールは、API インフラストラクチャの規模、複雑さ、監視のニーズによって異なります。
アラート戦略の構築効果的な API 監視戦略には、問題が発生したときに通知するアラートを設定する必要があります。考慮すべきアラートには主に 2 つのタイプがあります。
しきい値ベースのアラート
しきい値ベースのアラートは、メトリックが定義されたしきい値を超えるとトリガーされます。たとえば、API エラー率が 5% を超えた場合、または P99 応答時間が 1 秒を超えた場合に通知を受け取りたい場合があります。
しきい値を設定するときは、通常の運用中の履歴メトリック値を確認し、そのベースラインのわずかに外側にアラート トリガーを設定します。これは、意味のあるイベントを捕捉しながら、誤検知を回避するのに役立ちます。
異常検出アラート
異常検出は、異常なメトリック パターンでアラートを発行することにより、静的しきい値を超えます。これにより、時間の経過に伴うパフォーマンスのゆっくりとした低下などのイベントを捕捉できます。
異常検出は、履歴データを分析して通常の動作のモデルを構築することによって機能します。そのベースラインから大きく逸脱すると、アラートがトリガーされます。このアプローチには十分なメトリック履歴が必要ですが、しきい値ベースのアラートでは見逃される可能性がある問題を明らかにできます。
通知システムの統合
アラートを最大限に活用するには、アクションを実行できるシステムとアラートを統合します。オプションには、電子メール、SMS、チャット アプリケーション、PagerDuty などのインシデント管理ツールが含まれます。
通知の統合により、問題を担当チームに迅速に伝えることができます。これにより、調査と解決が迅速化され、API のダウンタイムが最小限に抑えられます。
グループの自動スケーリングやプレイブックの実行などの自動化されたアクションも、API の問題の影響を軽減するのに役立ちます。さまざまなアラートの重大度に基づいて、どの通知と応答が適切であるかを判断します。
API ヘルス データの視覚化と分析
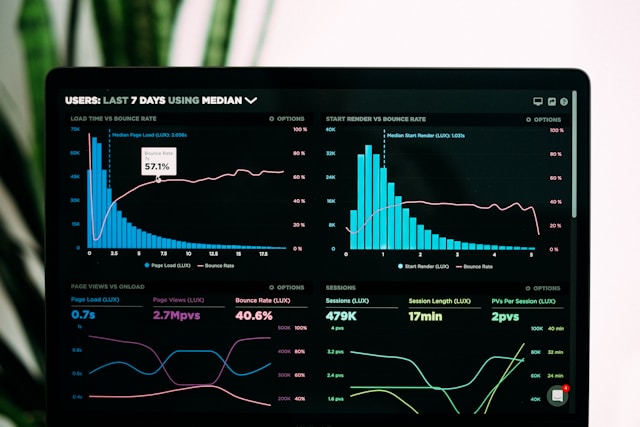
メトリクスの収集を開始したら、次のステップはデータを視覚化および分析して、API のパフォーマンスと健全性についての洞察を取得することです。カスタム ダッシュボードの構築は、API の健全性を監視するために重要です。単に生のメトリクス ストリームを監視するのではなく、適切に設計されたダッシュボードを使用すると、主要な傾向、異常、洞察を一目で明らかにできます。
ダッシュボード ツールを選択する際に注目すべき重要な機能には次のようなものがあります。
-
メトリクスの視覚的な相関関係 - メトリクスを並べて表示して関係を明らかにします。たとえば、エラー率とトラフィックをプロットして、高負荷時にエラーが急増するかどうかを確認します。
-
履歴分析 - 現在の傾向を過去の動作と比較して、異常を検出します。長期的な傾向を高いレベルで表示します。
-
柔軟なグラフ作成 - さまざまなグラフ タイプ、ローリング ウィンドウ、パーセンタイルなどの統計ビューを使用してグラフをカスタマイズします。- 注釈とコラボレーション - グラフにコンテキストを追加し、結果を同僚と共有します。
-
プログラムによるアクセス - ダッシュボード データをアラート、ワークフロー、その他のシステムと統合します。
-
事前定義されたダッシュボードとカスタム ダッシュボード - 事前に構築されたテンプレートを使用し、さまざまなチームやシナリオに合わせたカスタム ビューを作成します。
洞察力に優れたダッシュボードを導入すると、API チームは、問題がエスカレートしたり顧客に影響を与えたりする前に、問題を積極的に特定できます。徐々に増加するレイテンシー、エラーの増加と相関するトラフィックの急増、または異常な 5xx エラー率などの傾向を探します。ダッシュボードをエンジニアリングやカスタマーサポートなどの他のチームと共有して、問題をデバッグします。技術者以外の関係者でもダッシュボードを理解しやすくし、組織全体で API の健全性ステータスを伝達できるようにします。
API の使用状況と導入をモニタリングする
API がどのように使用および採用されているかを理解することは、API が価値を確実に提供するために重要です。追跡すべき重要な指標は次のとおりです。
API コール量
-
API 呼び出しの合計量を長期にわたって監視して、増加または減少の傾向を特定します。トラフィックの突然の急増または低下は、問題を示している可能性があります。
-
API トラフィックをエンドポイントごとにセグメント化して、最も人気のあるものと最も人気のないものを確認します。これは、今後の API 開発の取り組みの指針となります。
-
応答時間のパーセンタイル (95 パーセンタイルなど) を追跡して、API パフォーマンスを監視します。応答時間の増加は、スケーラビリティの問題を示している可能性があります。
ユーザーとアプリの内訳
-
開発者/アプリごとに API の使用状況を分析し、API 消費者ベース全体での採用を把握します。
-
大量の消費者と少量の消費者を特定します。上位の消費者に連絡して、何が彼らの使用を促進しているのかを学びましょう。
-
不正使用を示す可能性のある特定のアプリからの不審な使用量の急増に注意してください。
API ドキュメントへのアクセスを監視する
-
API リファレンス ドキュメントのページビューを追跡して、開発者の関心を評価します。
-
どのコード スニペット/サンプルが最も閲覧されているかを確認します。これにより、開発者がどの API 機能に最も関心を持っているかがわかります。
-
API ドキュメント検索クエリを監視して、ドキュメントの範囲内のギャップを特定します。文書化されていないトピックが頻繁に検索されるということは、開発者がより多くの API 情報を必要としていることを示しています。
コール量、応答時間、ドキュメントへのアクセスなどの指標を通じて API の導入を監視することは、API が意図した価値を確実に提供するための鍵となります。得られた使用状況に関する洞察により、API の改善、スケーラビリティ、セキュリティ、ドキュメントの強化に関してデータに基づいた意思決定を行うことができます。
API の健全性とビジネス指標の関連付けAPI の技術的な健全性を監視すると、重要な洞察が得られますが、ビジネスへの影響を最大化するには、API のパフォーマンスを主要なビジネス KPI と相関させる必要があります。これにより、API の問題による収益への影響を定量化し、それに応じて優先順位を付けることができます。
収益への影響のモニタリング
-
API 経由でトランザクションを追跡し、収益データと関連付けます。これにより、API のダウンタイムやパフォーマンスの低下による収益への影響を特定できます。
-
トランザクション ワークフローの各ステップで API エラー率の監視を設定します。 API エラーが主要なファネルとコンバージョンにどのような影響を与えるかを分析します。
-
顧客セグメント全体で API 使用状況の指標を比較します。 API のパフォーマンスの問題が価値の高い顧客に不釣り合いな影響を与えているかどうかを確認します。
ユーザーエンゲージメントの追跡
-
API コンシューマーのサインアップ率と維持率を測定します。 API の信頼性が低いと、ユーザー エンゲージメントの低下と直接相関することがよくあります。
-
新しい API 機能の導入を監視します。使用量の低下は、関心の欠如ではなく、API の品質の問題を示している可能性があります。
-
API エラー率とユーザー フィードバックの間の相関関係を探します。顧客からの苦情では、API の問題が指摘されることがよくあります。
API のビジネスへの影響をプロアクティブに監視することで、技術チームと製品チームが優先順位を一致させることができます。定量化された収益とエンゲージメント データを使用して、技術的な改善を目標にしてビジネス価値を最大化できます。
API モニタリングのベスト プラクティス
効果的な API 監視戦略を確立するには、従うべき重要なベスト プラクティスがいくつかあります。
-
測定可能な目標を立てる - 稼働時間、レイテンシー、エラー率、その他の指標について定量化可能な目標を設定して、API が期待を満たしているかどうかを確認します。明確な目標があると、問題をすぐに特定しやすくなります。
-
問題が発生したときだけでなく、継続的に監視します - 問題が発生したときに API の状態をチェックするだけではありません。継続的なモニタリングにより、ベースラインのパフォーマンスに関する洞察が得られ、異常を検出できるようになります。
-
可能な限り自動化 - 手動監視は時間がかかり、非効率的です。自動モニタリングにより、API の健全性を 24 時間 365 日追跡し、問題があればすぐに警告を受けることができます。自動化により、使用量の増加に応じたスケーリング監視も可能になります。
-
ユーザー エクスペリエンスに焦点を当てる - 技術的な指標だけでなく、API のパフォーマンスがエンド ユーザーにどのような影響を与えるかに常に焦点を当ててください。合成モニタリングでは、ユーザー シナリオをシミュレートして、ユーザーの観点から API の健全性を監視できます。- アラートは慎重に設定してください - アラートは問題を迅速に検出するために不可欠ですが、アラートを設定しすぎるとアラート疲れにつながる可能性があります。意味のあるしきい値を設定し、優先度に基づいてアラートをカスタマイズします。
-
既存のツールと監視を統合 - 既存のソフトウェア配信パイプライン、ロギング、APM ツールを活用して、API の健全性についてより適切に統合された洞察を取得します。
-
サードパーティの依存関係を監視する - 独自の API を監視するだけでなく、API が依存するサードパーティのサービスやデータベースの健全性も追跡します。
-
API の健全性とビジネス KPI を関連付けます - API モニタリング データを主要なビジネス指標と関連付けて、API の健全性が中核的なビジネス目標にどのような影響を与えるかを理解します。これは、モニタリング作業の ROI を実証するのに役立ちます。
結論
API は、最新のアプリケーションのアーキテクチャの重要な部分です。使用量が増加するにつれて、API の健全性とパフォーマンスを監視することが非常に重要になります。明確な目標と指標を確立し、適切な監視ツールを選択し、堅牢なアラートを構築することで、API パフォーマンスの動向を把握し続けることができます。
重要なポイントは次のとおりです。
-
稼働時間、遅延、エラー率などのビジネス目標に基づいて監視目標を定義します。
-
スループット、トラフィック ソース、応答時間、エラーなどの使用状況メトリクスを追跡します。環境全体を監視します。
-
API メトリクスの収集、視覚化、アラートを行うための専用ツールを使用します。既存のロギングおよび APM ソリューションと統合します。
-
しきい値を設定し、インテリジェントなアラートを構成して、異常を検出し、問題が検出されないことを防ぎます。
-
長期にわたる傾向を分析して、パフォーマンスを最適化し、問題を回避します。 API の健全性をビジネス KPI と関連付けます。
-
モニタリングを自動化し、チーム全体でそれを優先します。本番環境に対応した API のベスト プラクティスに従ってください。
モニタリングにより、API をスムーズに実行し続けるために必要な洞察が得られます。しっかりとした監視戦略を確立することで、応答性、信頼性、回復力に優れた API を開発者や顧客に提供できます。必要な努力にはそれだけの価値があります。
このエキサイティングな分野に関するさらなる洞察と最新情報については、引き続き APIRobots をご覧ください。API があなたのビジネスにもたらす可能性のある機会をお見逃しなく。今すぐ API Robots または API 開発庁) までお問い合わせください。一緒に API の可能性を最大限に引き出しましょう。